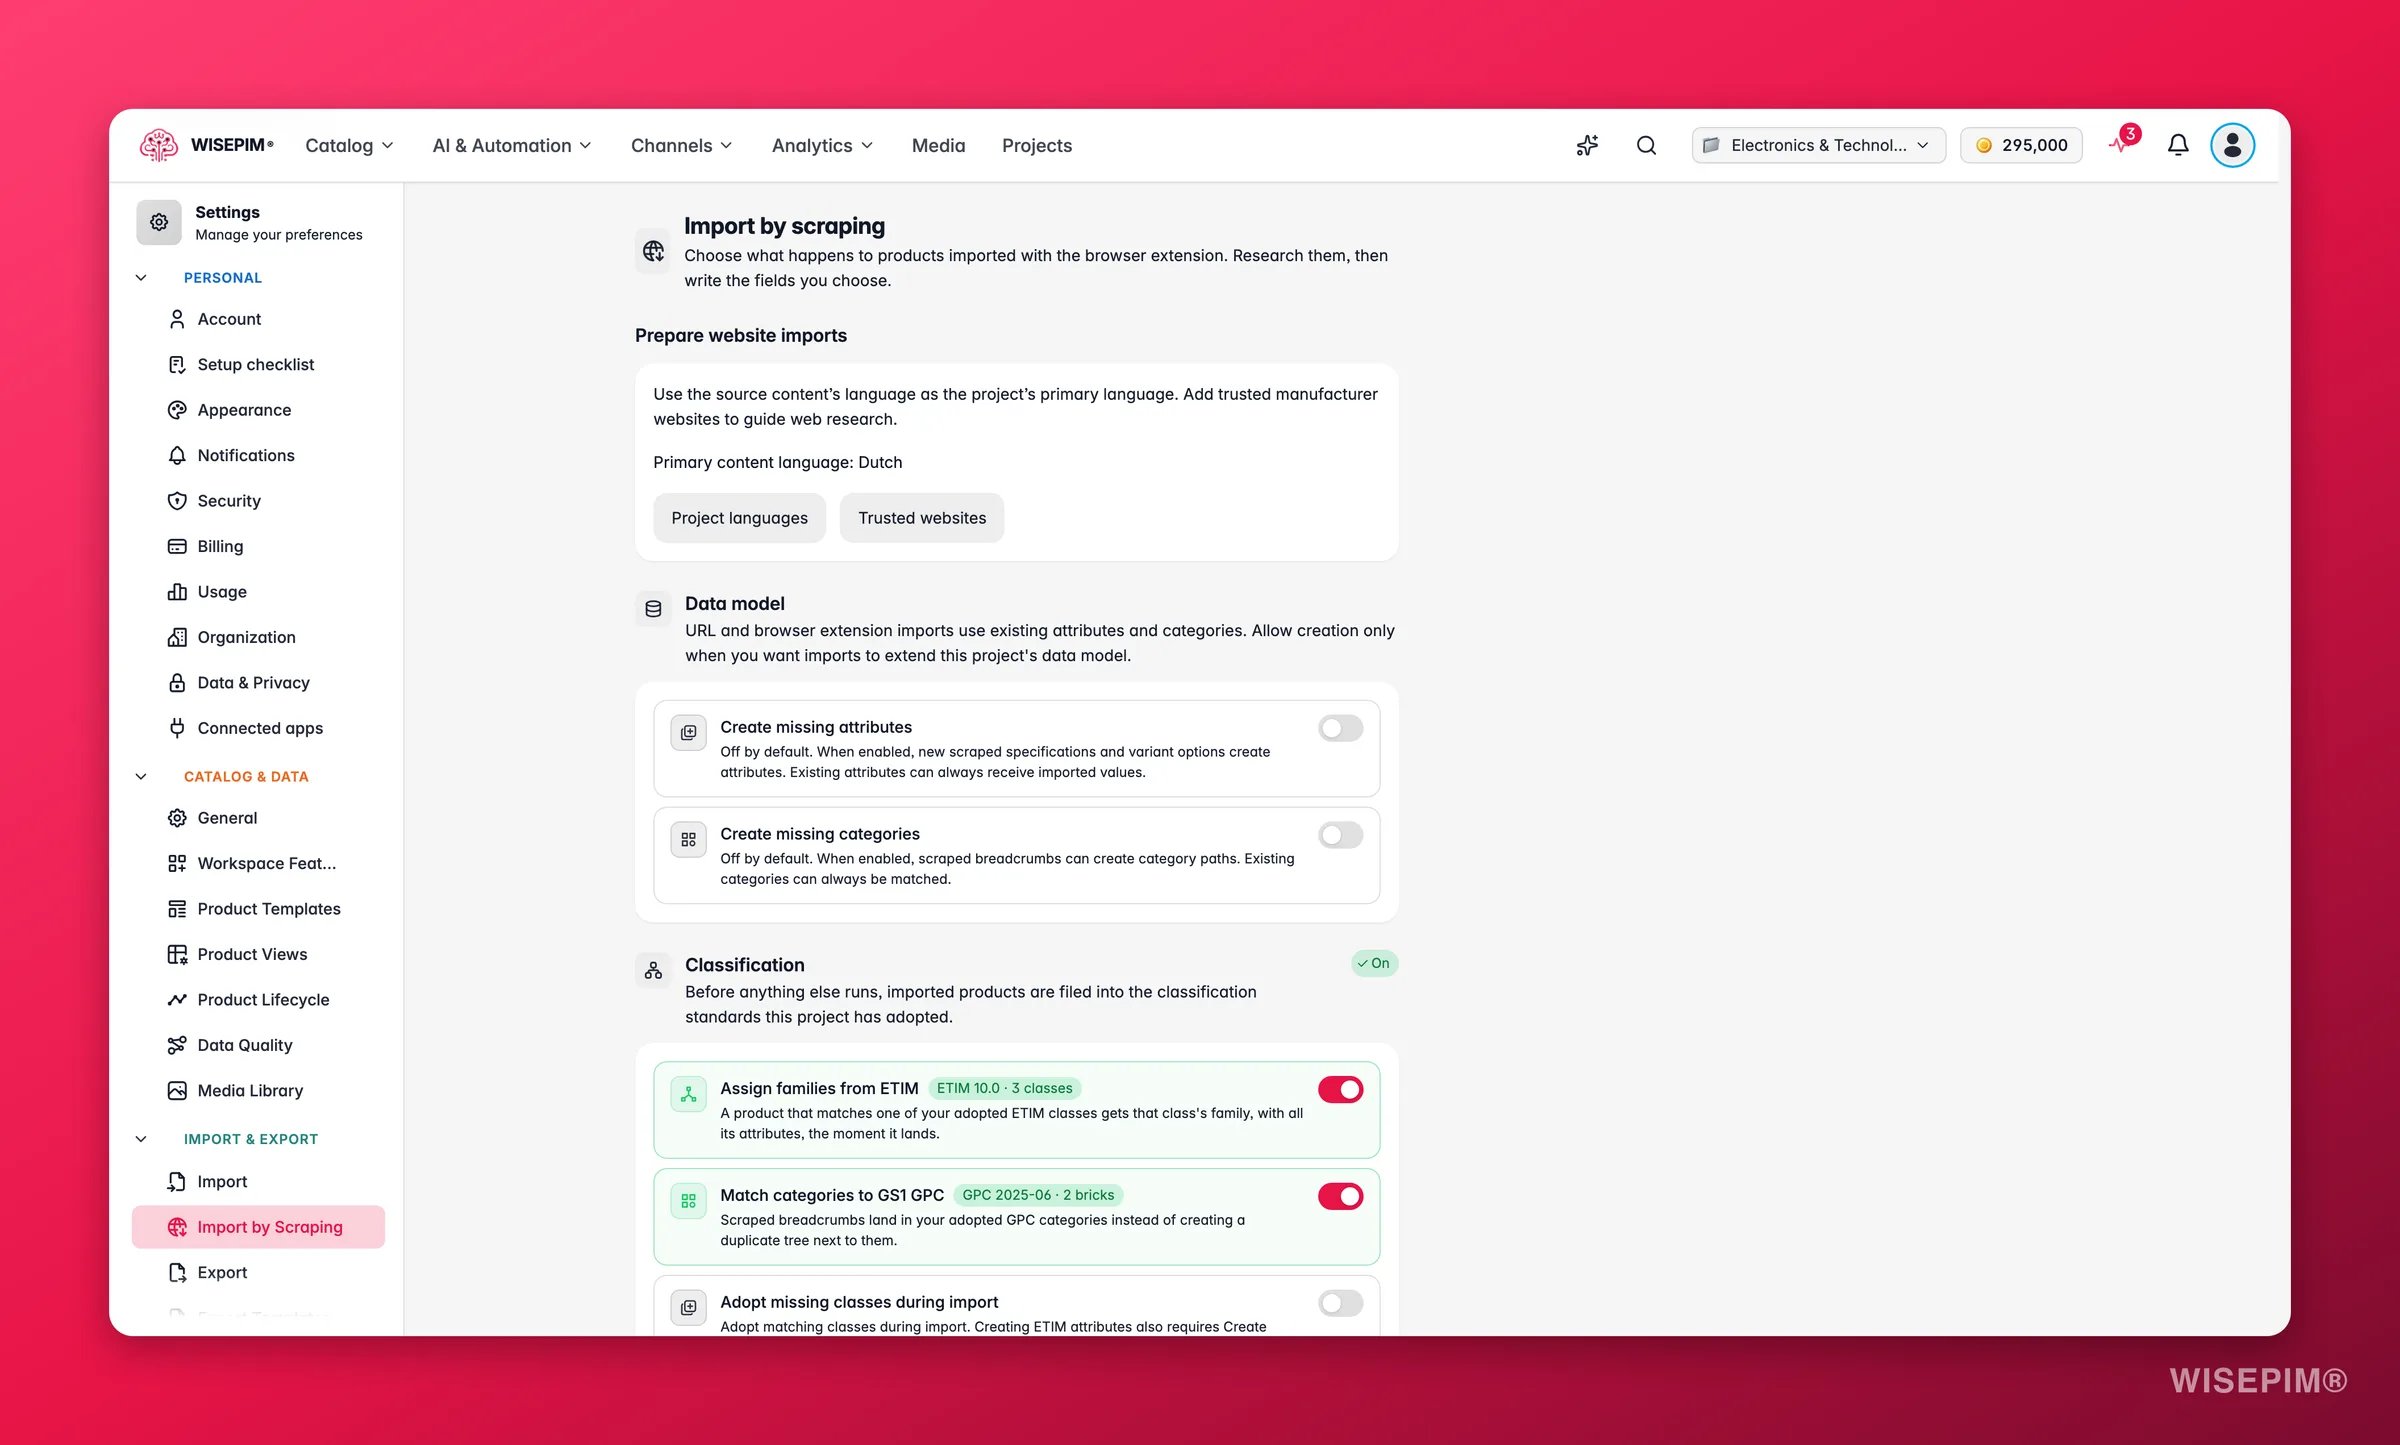
Diese Einstellungen gelten projektweit. Die Browser-Erweiterung kann die Anreicherungskette für einen einzelnen Import überspringen (praktisch, wenn du ein Produkt nur zum Ansehen hereinholst), aber die Klassifikation läuft immer. Sie ist kostenlos und strukturell.
Website-Importe vorbereiten
Zwei Links helfen vor deinem ersten Import:- Projektsprachen: zeigt die Hauptsprache der Inhalte. Stell sie auf die Sprache der Websites, von denen du importierst, damit die Inhalte in der richtigen Sprache landen.
- Vertrauenswürdige Websites: füg Herstellerwebsites hinzu, um die Web-Recherche zu lenken.
Datenmodell
Standardmäßig füllen Importe aus der Erweiterung die Attribute und Kategorien, die du schon hast. Erlaube das Anlegen nur, wenn Importe das Datenmodell dieses Projekts erweitern sollen.Projekte, die seit dem 19. Oktober 2026 erstellt wurden, starten mit Fehlende Attribute erstellen an und Fehlende Kategorien erstellen aus, damit die Spezifikationen eines ersten Imports nicht verloren gehen. Ältere Projekte behalten ihre gespeicherte Einstellung, und die ist für beide aus, sofern du sie nicht geändert hast.
Klassifikation
Wenn dein Projekt Klassifikationsstandards übernommen hat, werden importierte Produkte darin einsortiert, bevor irgendetwas anderes läuft:
Der Bereich zeigt, auf welchem Release du bist und wie viele Klassen oder Bricks du übernommen hast (zum Beispiel “ETIM 10.0 · 24 Klassen”). Solange du noch keinen Standard übernommen hast, bleiben die Schalter inaktiv, und der Bereich verlinkt dich auf ETIM-Klassen durchsuchen und GPC-Kategorien durchsuchen, um das zuerst einzurichten.
Nach einem Import: die Anreicherungskette
Schalte Gescrapte Produkte automatisch anreichern an, und die Schritte unten laufen der Reihe nach, sobald ein Import aus der Erweiterung abgeschlossen ist.Schritt 1: Web-Recherche
Schlägt jedes Produkt im Web nach und führt die geprüften Fakten zuerst zusammen, damit der Schreibschritt auf echten Informationen aufbauen kann. Das kostet Recherche-Credits pro Produkt, und die Anreicherung wartet, bis die Recherche vorliegt, bevor sie schreibt. Dieser Schritt braucht den Pro-Tarif oder höher. Ohne ihn kannst du die Web-Recherche weiterhin manuell aus der Produkttabelle starten. Wie sich die Recherche verhält (Fokus, erlaubte Quellen, welche Felder sie aktualisieren darf), kommt aus den Web-Recherche-Einstellungen.Schritt 2: Die Inhalte schreiben
Die Bulk-Anreicherung schreibt jedes von dir gewählte Feld und nutzt dabei den Standard-Prompt des Projekts, sofern du pro Feld keinen anderen wählst:- Beschreibungen
- Kurzbeschreibungen
- Titel
- SEO-Titel und Meta
- Attribute
Verwandte Themen
Web-Scraping-Import
Importiere Produkte mit der Browser-Erweiterung.
Klassifizierung (ETIM & GS1 GPC)
Übernimm die ETIM-Klassen und GPC-Kategorien, in die Importe einsortiert werden.
Web-Recherche-Einstellungen
Steuere, worauf sich die Recherche konzentriert und welche Felder sie aktualisiert.
Bulk-Anreicherung
Der Schreibschritt der Kette, auch einzeln verfügbar.