Estos ajustes se aplican a todo el proyecto. La extensión de navegador puede omitir la cadena de enriquecimiento en una importación concreta (útil cuando capturas un producto solo para echarle un vistazo), pero la clasificación se ejecuta siempre. Es gratuita y estructural.
Preparar importaciones de sitios web
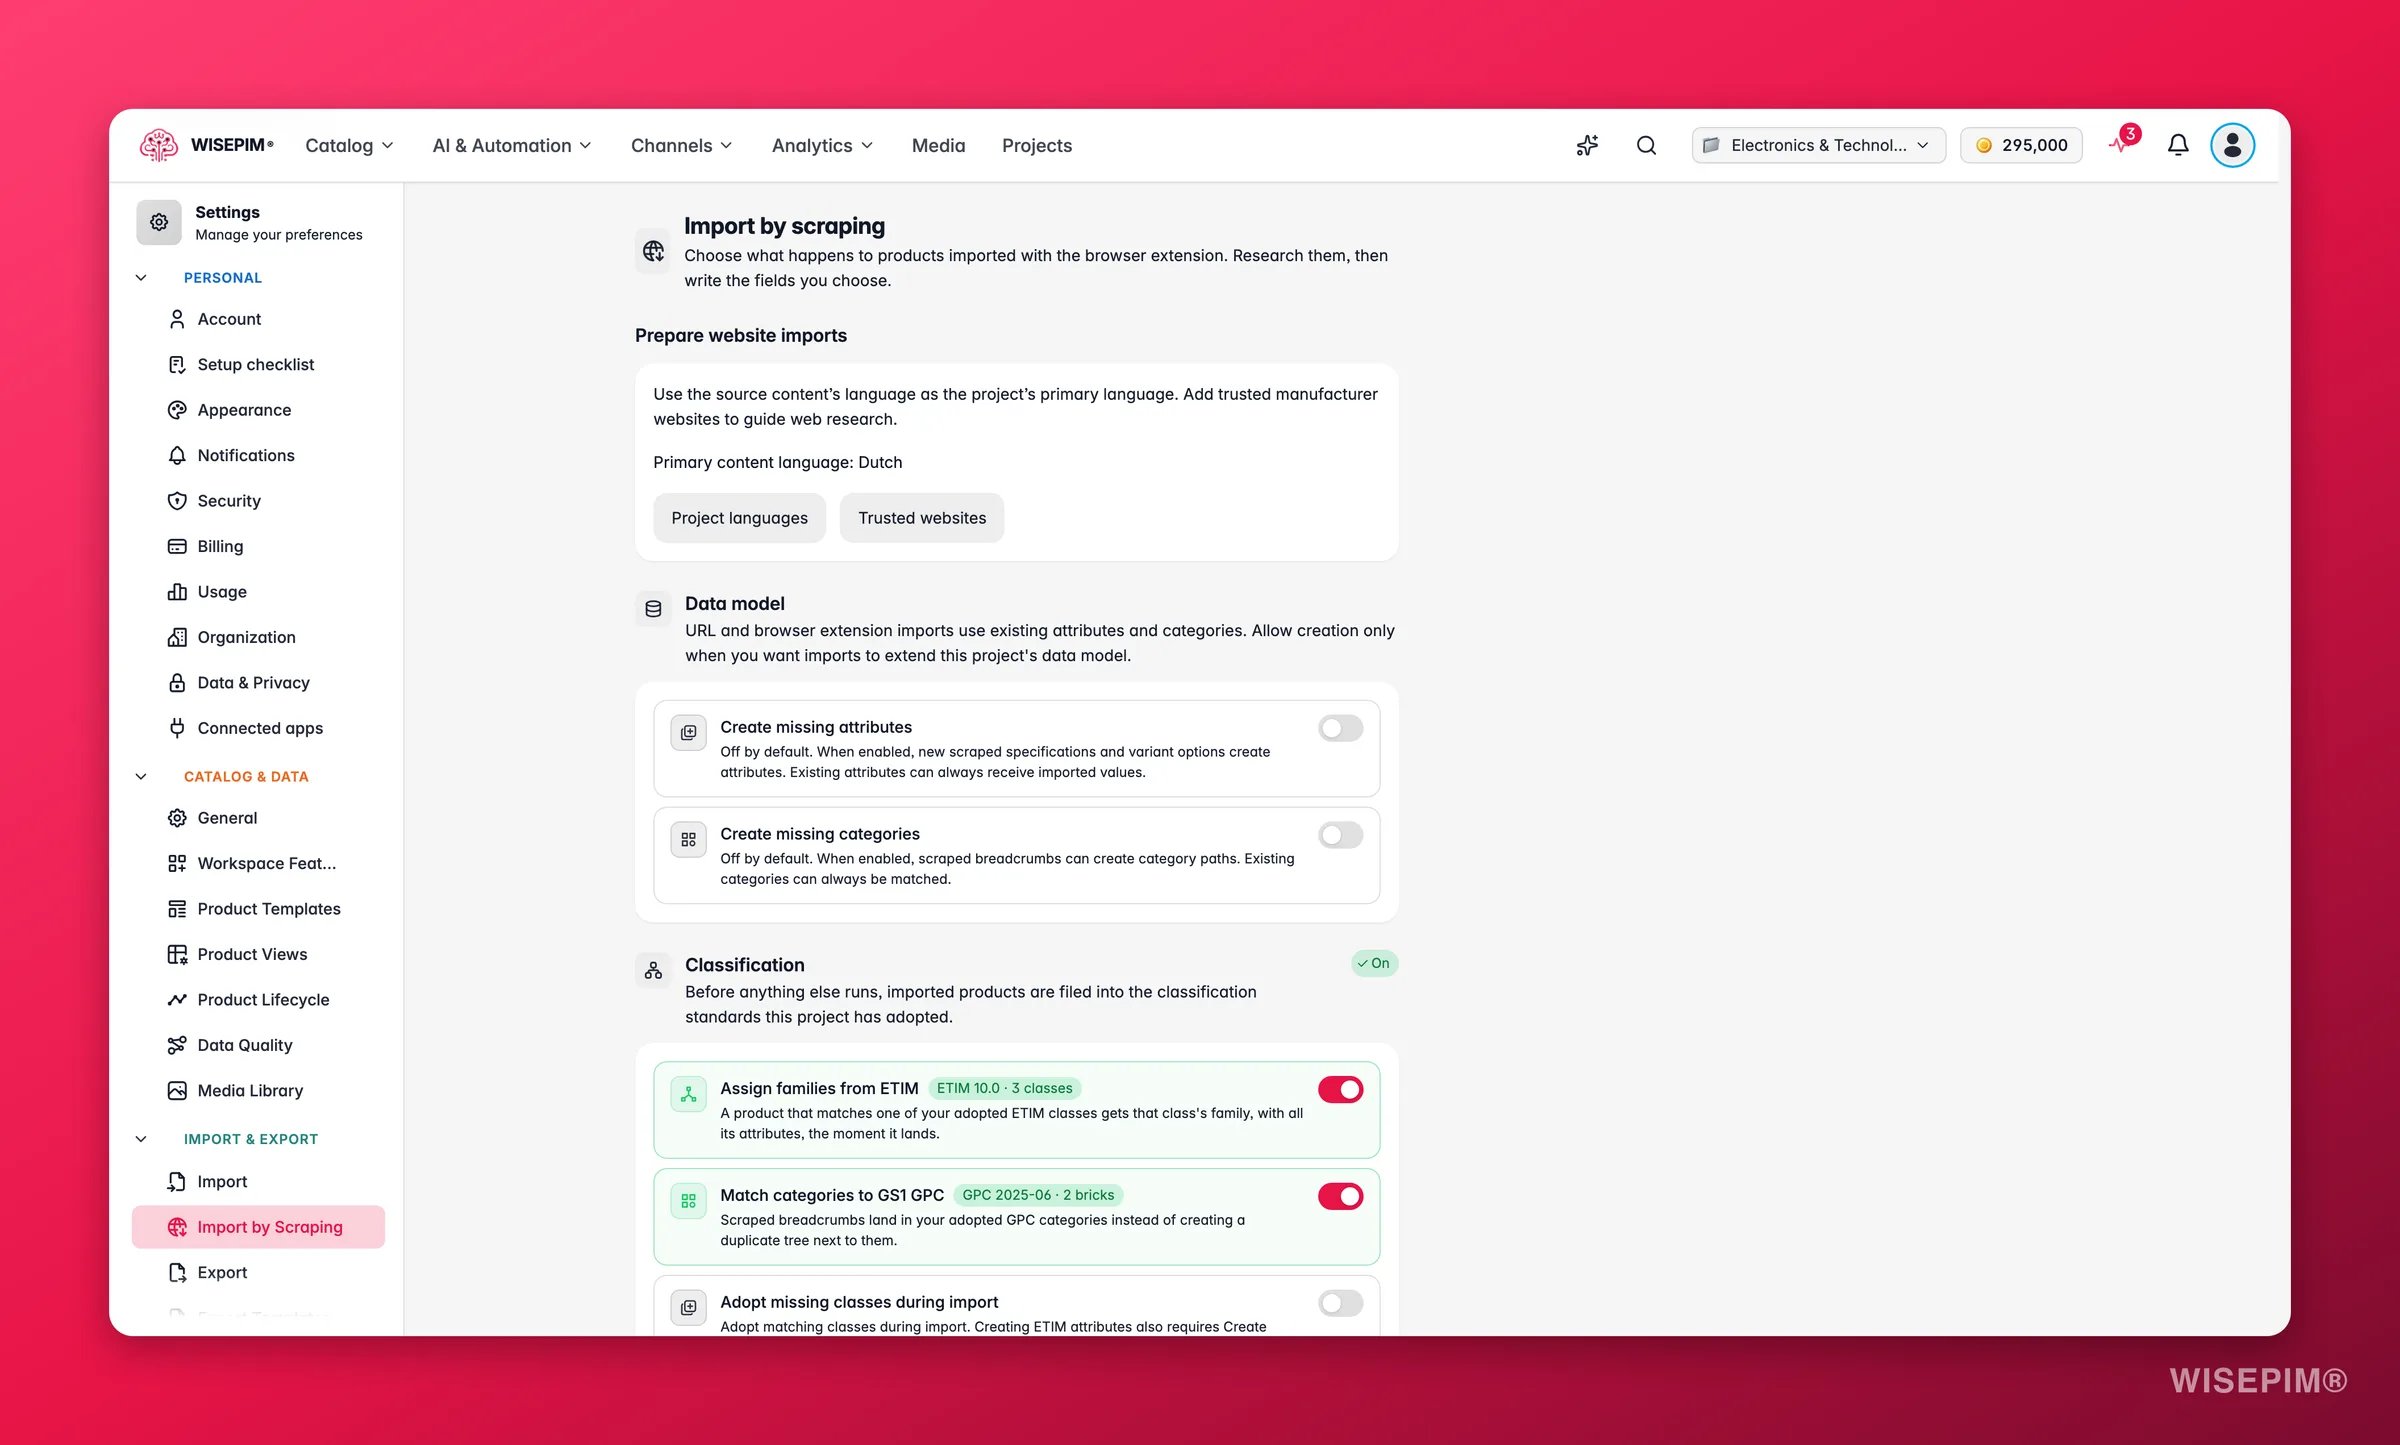
Dos enlaces te ayudan antes de tu primera importación:- Idiomas del proyecto: muestra el Idioma principal del contenido. Ponlo en el idioma de los sitios desde los que importas, para que el contenido llegue en el idioma correcto.
- Sitios web de confianza: añade sitios web de fabricantes para orientar la investigación web.
Modelo de datos
Por defecto, las importaciones de la extensión rellenan los atributos y las categorías que ya tienes. Permite la creación solo cuando quieras que las importaciones amplíen el modelo de datos de este proyecto.Los proyectos creados desde el 19 de octubre de 2026 empiezan con Crear atributos faltantes activado y Crear categorías faltantes desactivado, para que no se pierdan las especificaciones de una primera importación. Los proyectos anteriores conservan su ajuste guardado, que está desactivado en ambos salvo que lo cambiaras.
Clasificación
Si tu proyecto ha adoptado estándares de clasificación, los productos importados se archivan en ellos antes de que se ejecute cualquier otra cosa:
La sección muestra en qué versión estás y cuántas clases o bricks has adoptado (por ejemplo «ETIM 10.0 · 24 clases»). Hasta que hayas adoptado al menos un estándar, los interruptores permanecen inertes y la sección te enlaza a Explorar clases ETIM y Explorar categorías GPC para configurarlo primero.
Después de una importación: la cadena de enriquecimiento
Activa Enriquecer automáticamente los productos scrapeados y los pasos siguientes se ejecutan, en orden, cada vez que finaliza una importación con la extensión.Paso 1: Investigación web
Busca cada producto en la web y fusiona primero los datos verificados, para que el paso de redacción parta de información real. Esto consume créditos de investigación por producto, y el enriquecimiento espera a que llegue la investigación antes de escribir. Este paso requiere el plan Pro o superior. Sin él, aún puedes ejecutar la investigación web a mano desde la tabla de productos. Cómo se comporta la investigación (el enfoque, las fuentes permitidas, qué campos puede actualizar) viene de los ajustes de investigación web.Paso 2: Escribe el contenido
El Enriquecimiento masivo escribe cada campo que elijas, usando el prompt predeterminado del proyecto salvo que selecciones otro por campo:- Descripciones
- Descripciones cortas
- Títulos
- Título SEO y meta
- Atributos
Relacionado
Importación por web scraping
Importa productos con la extensión de navegador.
Clasificación (ETIM y GS1 GPC)
Adopta las clases ETIM y las categorías GPC en las que se archivan las importaciones.
Ajustes de investigación web
Controla en qué se centra la investigación y qué campos actualiza.
Enriquecimiento masivo
El paso de redacción de la cadena, también disponible por sí solo.