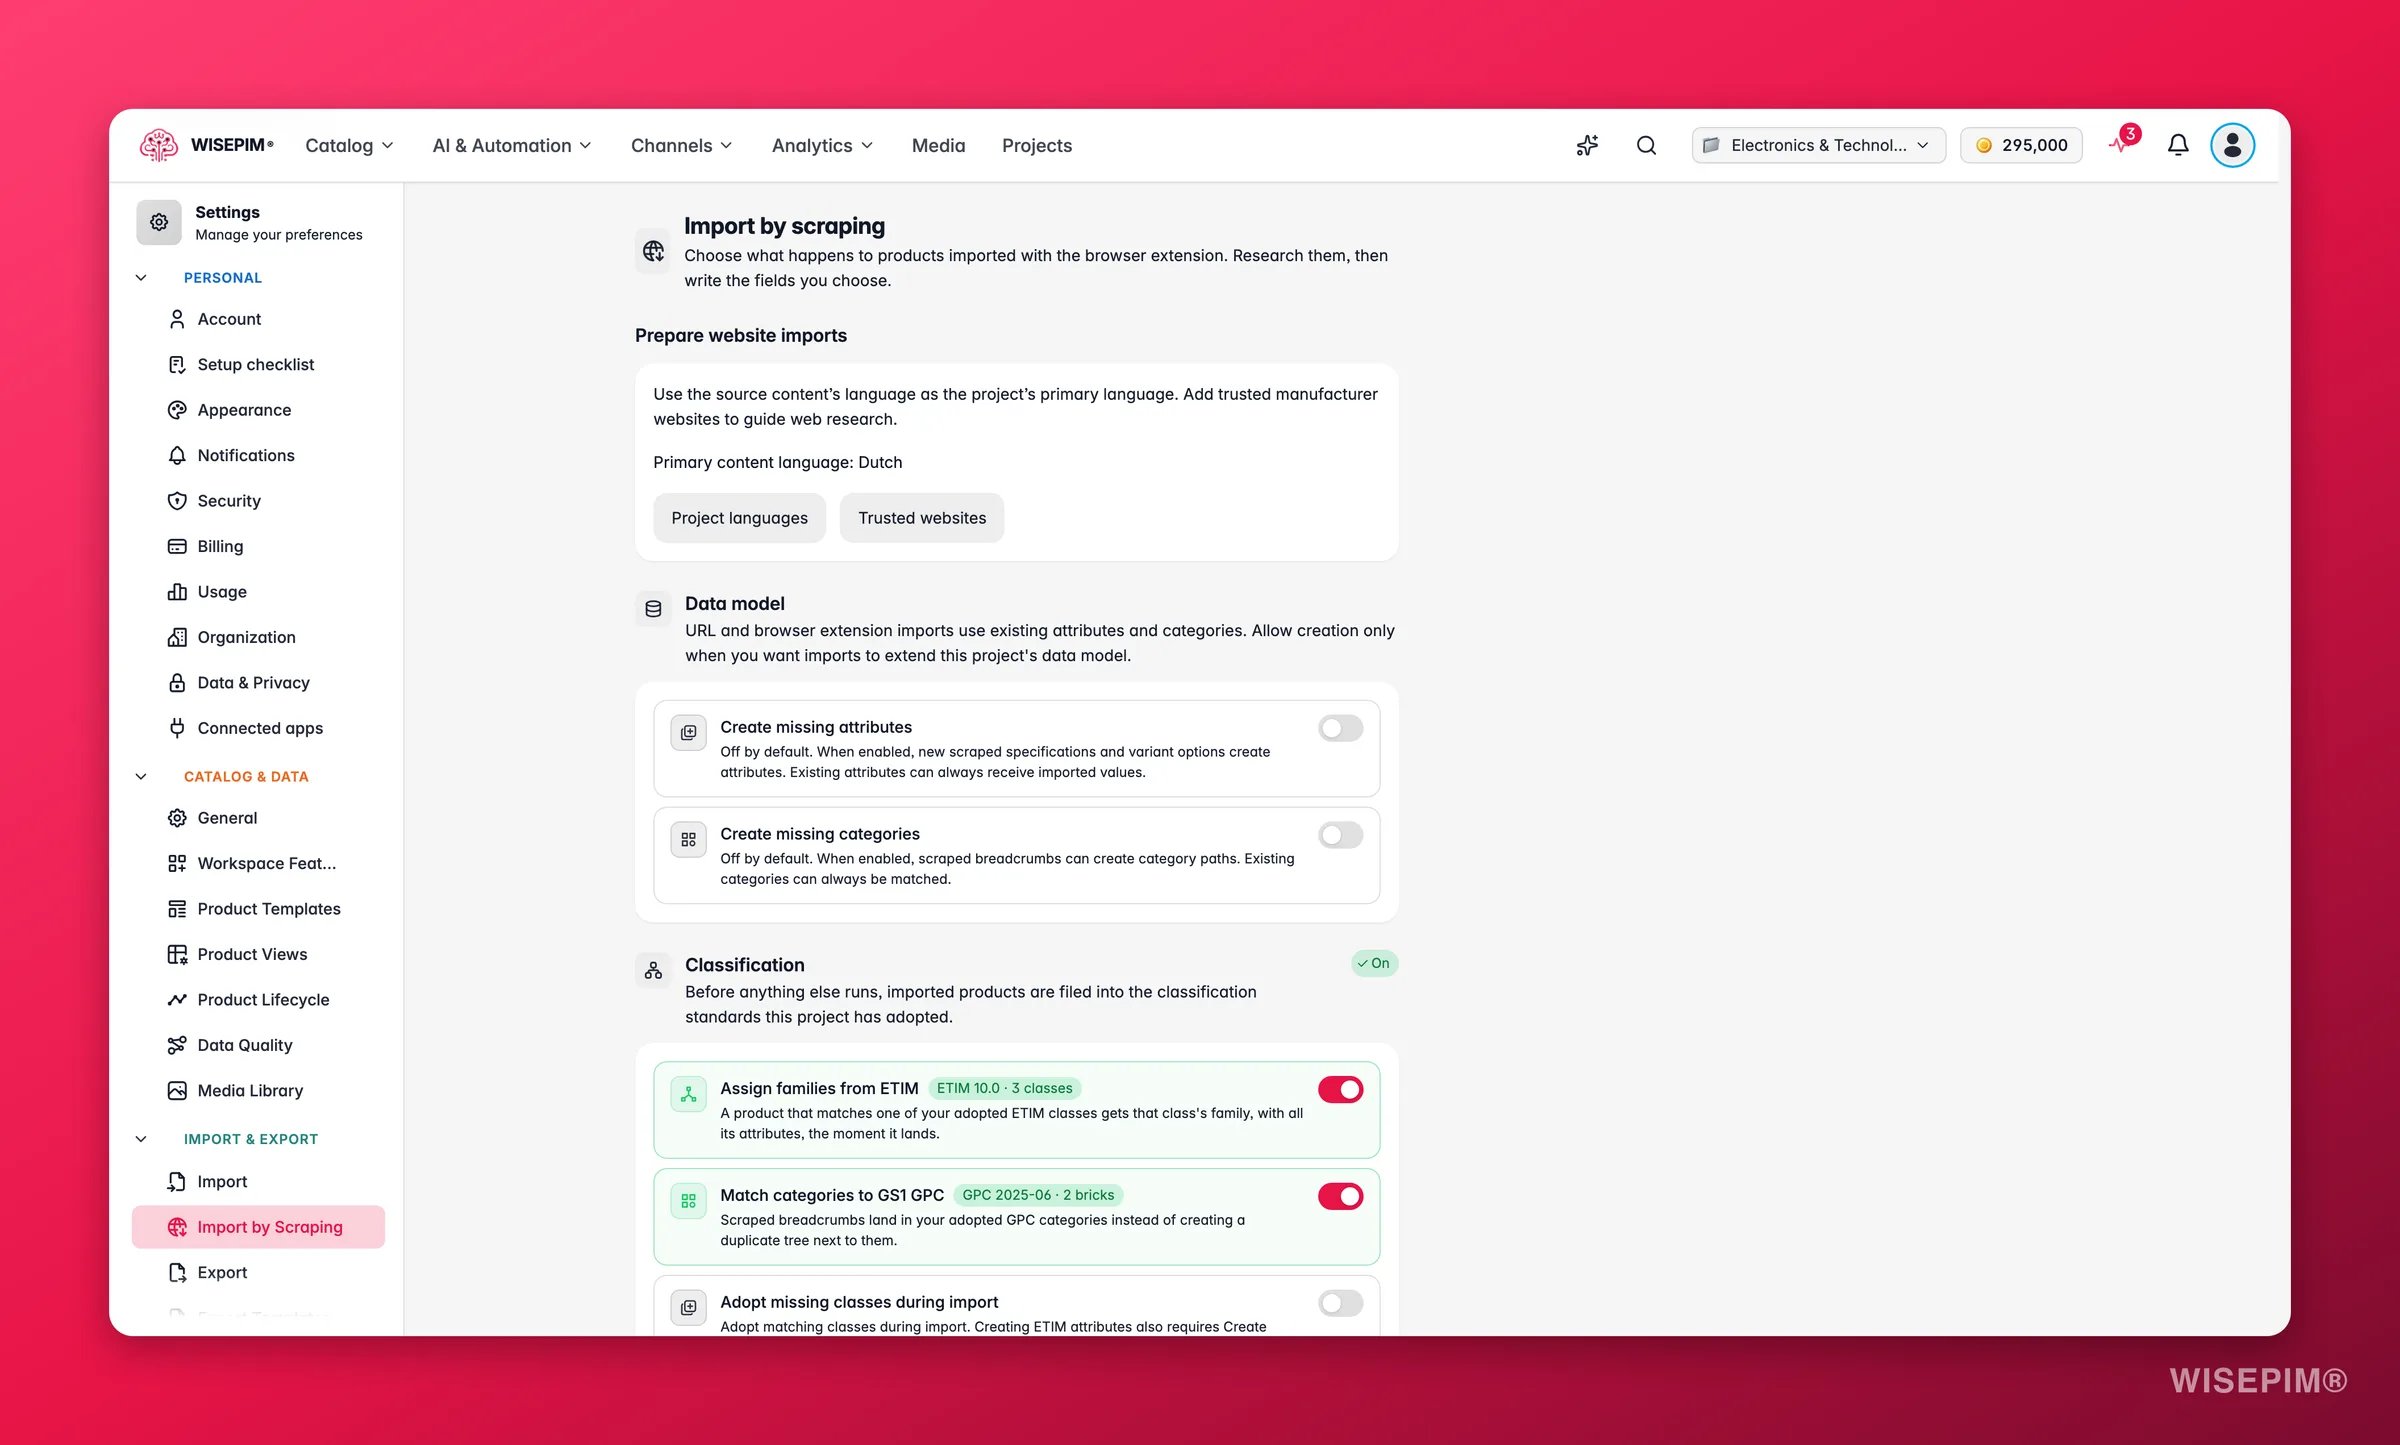
Deze instellingen gelden voor het hele project. De browserextensie kan de verrijkingsketen voor één import overslaan (handig wanneer je één product binnenhaalt om er alleen even naar te kijken), maar classificatie draait altijd. Die is gratis en structureel.
Website-import voorbereiden
Twee links helpen je vóór je eerste import:- Projecttalen: toont de Primaire inhoudstaal. Stel die in op de taal van de sites waarvan je importeert, zodat de content in de juiste taal landt.
- Vertrouwde websites: voeg fabrikantwebsites toe om webonderzoek te sturen.
Datamodel
Standaard vullen imports via de extensie de attributen en categorieën die je al hebt. Sta aanmaken alleen toe als je wilt dat imports het datamodel van dit project uitbreiden.Projecten die sinds 19 oktober 2026 zijn aangemaakt, beginnen met Ontbrekende attributen aanmaken aan en Ontbrekende categorieën aanmaken uit, zodat de specificaties van een eerste import niet verloren gaan. Oudere projecten houden hun opgeslagen instelling, en die staat voor beide uit tenzij je hem hebt gewijzigd.
Classificatie
Heeft je project classificatiestandaarden overgenomen, dan worden geïmporteerde producten daarin ingedeeld voordat er iets anders draait:
De sectie toont op welke release je zit en hoeveel klassen of bricks je hebt overgenomen (bijvoorbeeld “ETIM 10.0 · 24 klassen”). Tot je minstens één standaard hebt overgenomen, blijven de schakelaars inactief en verwijst de sectie je naar ETIM-klassen bekijken en GPC-categorieën bekijken om dat eerst in te stellen.
Na een import: de verrijkingsketen
Zet Gescrapete producten automatisch verrijken aan en de stappen hieronder draaien, in volgorde, zodra een import via de extensie klaar is.Stap 1: Webonderzoek
Zoekt elk product op het web op en voegt eerst de geverifieerde feiten samen, zodat de schrijfstap iets echts heeft om mee te werken. Dit kost onderzoekscredits per product, en de verrijking wacht tot het onderzoek binnen is voordat er wordt geschreven. Deze stap vereist het Pro-abonnement of hoger. Zonder dat abonnement kun je webonderzoek nog steeds handmatig starten vanuit de productentabel. Hoe het onderzoek zich gedraagt (focus, toegestane bronnen, welke velden het mag bijwerken) komt uit de instellingen voor webonderzoek.Stap 2: Schrijf de content
Bulkverrijking schrijft elk veld dat je kiest, met de standaardprompt van het project tenzij je per veld een andere kiest:- Beschrijvingen
- Korte beschrijvingen
- Titels
- SEO-titel en meta
- Kenmerken
Gerelateerd
Web scraping-import
Importeer producten met de browserextensie.
Classificatie (ETIM & GS1 GPC)
Neem de ETIM-klassen en GPC-categorieën over waarin imports worden ingedeeld.
Instellingen voor webonderzoek
Bepaal waar onderzoek zich op richt en welke velden het bijwerkt.
Bulkverrijking
De schrijfstap van de keten, ook los te gebruiken.